llms.txt står på min egen GEO-tjekliste. Jeg sætter den op for kunder, og mit site har også én. Så jeg gjorde endelig det, jeg burde have gjort, før jeg anbefalede den: Jeg åbnede mine serverlogs og tjekkede, hvem der rent faktisk læser den.
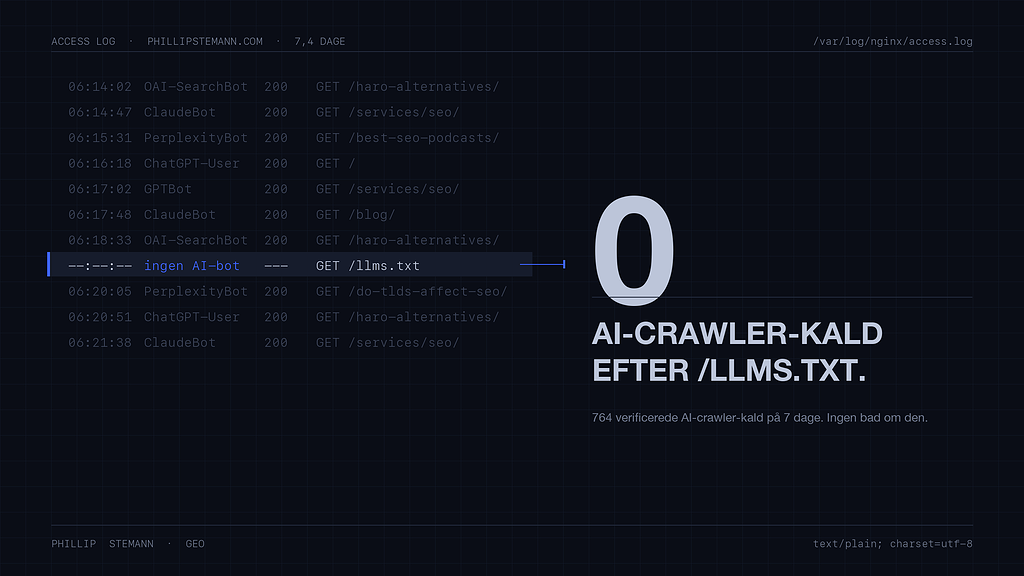
Svaret, efter en uges logs og med hver AI-crawler tjekket mod virksomhedens officielle IP-liste: ingen. Ikke én rigtig AI-crawler bad om min llms.txt. Rigtig mange af dem besøgte resten af mit site.
Den korte version:
- På 7,4 dage (8.-15. oktober 2026) lavede verificerede AI-crawlere fra OpenAI, Anthropic og Perplexity 764 forespørgsler på mit site.
- Nul af dem var efter /llms.txt.
- Filen blev hentet 11 gange i alt: af SEO- og tech-opslagsværktøjer, af tre personer i en browser og af mig, mens jeg testede.
- AI-crawlerne læste i stedet almindelige sider: forsiden, min liste over HARO-alternativer, min SEO-ydelse og min Search Console-guide.
Hvad llms.txt er (og ikke er)
llms.txt er en Markdown-fil i roden af dit site, der lister dine vigtigste sider, så en sprogmodel kan finde det gode indhold uden at skulle igennem navigation og scripts. Den blev foreslået af Jeremy Howard fra Answer.AI i september 2024 (her er forslaget).
Det er et forslag, ikke en standard. Den styrer ikke adgang: Det er stadig robots.txt, der bestemmer, hvilke crawlere der må hente hvad. Og ingen af de store AI-firmaer har offentligt lovet at læse den. Min bliver genereret automatisk af Rank Math, som er sådan de fleste WordPress-sites får én.
Sådan tjekkede jeg det
- Data: nginx-adgangslogs for phillipstemann.com fra 8. til 15. oktober 2026. 69.015 forespørgsler i alt.
- Intet skjult af CDN’et: Mit site kører bag Cloudflare, som besvarer nogle forespørgsler fra sin egen cache, før de når min server. Jeg tjekkede headerne: llms.txt bliver ikke cachet hos Cloudflare (
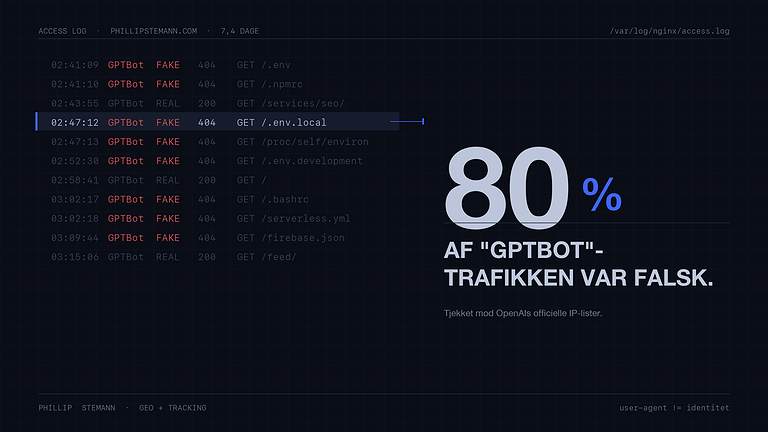
cf-cache-status: DYNAMIC), så hver forespørgsel efter den når min server og står i loggen. - Kun rigtige bots: Alle kan skrive “GPTBot” i en user agent, og mange scannere gør det. Så jeg talte kun en forespørgsel som GPTBot, ClaudeBot eller PerplexityBot, hvis IP-adressen stod på den liste, virksomheden selv offentliggør. Mere om det nedenfor, for det viste sig at betyde meget.
Resultatet: nul
| Crawler (verificeret) | Hvad den gør | Forespørgsler | Bad om llms.txt |
|---|---|---|---|
| OAI-SearchBot | Bygger ChatGPTs søgeindeks | 453 | 0 |
| ClaudeBot | Anthropics crawler | 176 | 0 |
| ChatGPT-User | Henter en side live, når nogen spørger ChatGPT | 56 | 0 |
| PerplexityBot | Bygger Perplexitys indeks | 51 | 0 |
| GPTBot | Indsamler træningsdata til OpenAI | 27 | 0 |
| Claude-User | Henter en side live for en Claude-bruger | 1 | 0 |
| I alt | 764 | 0 |
Googles, Bings og Apples crawlere bad heller ikke om den.
Hvem gjorde så? Fem af de 11 forespørgsler kom fra SEO- og tech-opslagsværktøjer (SEOJuice, BuiltWith og Keywords Everywhere), tre fra personer, der åbnede filen i en almindelig browser, og tre fra mig, der testede med curl. Med andre ord: SEO-værktøjer og SEO-folk læser llms.txt. AI-crawlere gør ikke.
Hvad AI-crawlerne læste i stedet
De havde travlt, bare ikke med llms.txt. De sider, de hentede mest, var forsiden, min liste over HARO-alternativer, min SEO-ydelse, min Google Search Console-guide og min liste over SEO-podcasts.
Den mest interessante er ChatGPT-User. Den crawler ikke i baggrunden; den henter en side, når et rigtigt menneske spørger ChatGPT om noget, og ChatGPT beslutter at læse din side for at svare. Den hentede 14 af mine sider 56 gange i den uge. Det er ChatGPT, der læser mit indhold for at besvare spørgsmål, og den gik direkte til siderne, ikke til en opsummeringsfil.
Forbehold, for én uge på ét site er ikke alt
- Det er ét site. Et stort site kan opleve noget andet. Har du ét, så tjek dine egne logs (jeg viser hvordan nedenfor).
- Det er én uge. En crawler kunne i teorien hente llms.txt én gang om måneden. Men 764 verificerede forespørgsler og ikke én efter filen er et tydeligt signal.
- Tingene ændrer sig. Hvis et AI-firma begynder at bruge llms.txt i morgen, viser de her data det ikke. Jeg kører tjekket igen jævnligt og opdaterer indlægget.
Skal du så have en llms.txt?
Behold den, hvis du har én. Den er gratis, den skader ikke, og er du på WordPress, laver Rank Math eller Yoast den med ét klik. Bare forvent ikke, at den gør noget for din synlighed i AI lige nu, og betal ikke nogen for at “optimere” den.
Det, loggene viser betyder noget, er det, AI-crawlerne faktisk henter: dine sider. Så det arbejde, der betaler sig, er det samme som god teknisk SEO:
- Luk crawlerne ind. Tjek robots.txt og dit CDN’s bot-indstillinger, så du ikke blokerer OAI-SearchBot, ChatGPT-User eller PerplexityBot ved et uheld.
- Lever rigtig HTML. Hvis dit indhold først dukker op, når JavaScript har kørt, ser mange AI-crawlere det ikke.
- Skriv sider, der besvarer konkrete spørgsmål klart, med fakta og tal, en model kan citere.
- Bliv nævnt på andre sites. AI-assistenter danner sig et billede af dig ud fra, hvad andre skriver, ikke kun ud fra dine egne sider.
Det er det arbejde, jeg laver i min GEO-ydelse, og jeg har siden flyttet llms.txt over i bunken med “valgfrit” på min egen tjekliste.
Sådan tjekker du dit eget site
Har du adgang til dine serverlogs, tager det to minutter:
grep "llms.txt" /path/to/access.logSer du GPTBot, ClaudeBot eller PerplexityBot i resultatet, så stol ikke på navnet. De fleste “AI-crawlere” i mine logs var falske. Her er, hvordan jeg tjekkede, hvilke AI-crawlere der var ægte, inklusiv det script, jeg brugte.