Første gang jeg søgte i mine serverlogs efter AI-crawlere, så billedet alarmerende ud: hundredvis af forespørgsler fra GPTBot, ClaudeBot og PerplexityBot, og de fleste endte i fejl. Det lignede, at AI-firmaerne hamrede løs på mit site og intet fik.
Så tjekkede jeg IP-adresserne. De fleste af de “AI-crawlere” var slet ikke AI-crawlere. Det var sårbarhedsscannere i et AI-firmas navn, der ledte efter adgangskoder og API-nøgler.
Her er, hvad jeg fandt i en uges logs, hvorfor det betyder noget for både sikkerhed og GEO, og det korte script, jeg brugte, så du kan køre samme tjek på dit eget site.
Den korte version:
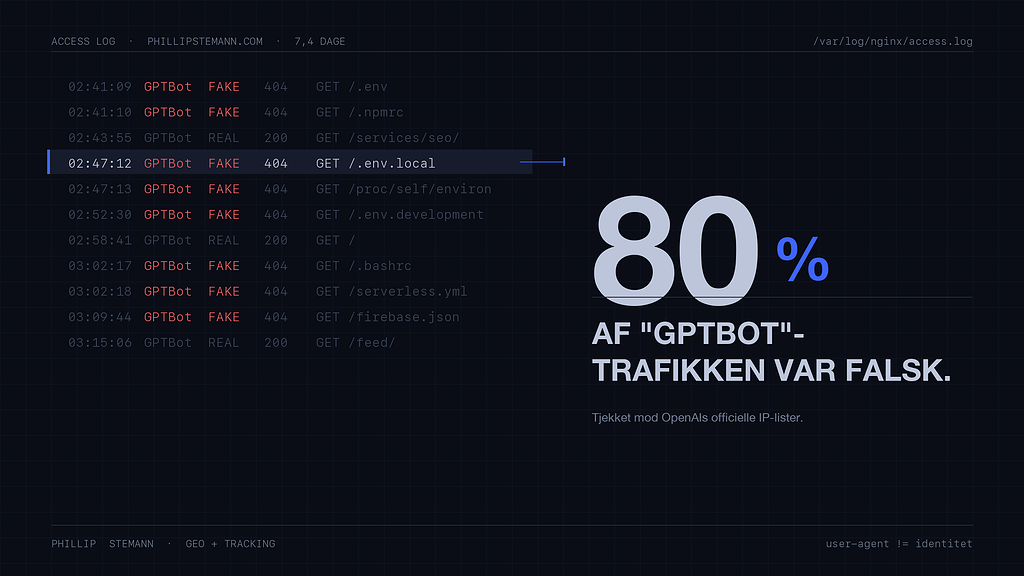
- 80 % af de forespørgsler, der kaldte sig GPTBot, var falske. For Perplexity-User var det 100 %.
- De falske crawlede ikke indhold. De ledte efter filer som .env, cloud-adgangsnøgler og Kubernetes-tokens.
- De rigtige crawlere opførte sig pænt: Næsten alle deres forespørgsler lykkedes.
- Den rigtige ChatGPT-User hentede mine sider 56 gange på en uge, men kun 2 besøg kom fra ChatGPT. Analytics viser dig kun de 2.
Tre slags AI-bots
Før man tæller noget, hjælper det at vide, at hvert AI-firma kører flere bots til forskellige opgaver. Det har forskellige konsekvenser at blokere eller tillade dem (se OpenAIs dokumentation for detaljerne om OpenAIs).
| Opgave | OpenAI | Anthropic | Perplexity | Hvad det betyder for dig |
|---|---|---|---|---|
| Træning | GPTBot | ClaudeBot | – | Dit indhold kan ende i fremtidige modeller |
| Søgeindeks | OAI-SearchBot | Claude-SearchBot | PerplexityBot | Om du overhovedet kan dukke op i AI-søgesvar |
| Live-hentning for en bruger | ChatGPT-User | Claude-User | Perplexity-User | Nogen har stillet et spørgsmål, og AI’en læser din side lige nu |
Hvad jeg målte
Jeg tog nginx-adgangslogs for phillipstemann.com fra 8. til 15. oktober 2026 (69.015 forespørgsler) og sammenlignede hver forespørgsel, der påstod at være en AI-crawler, med den IP-liste, firmaet selv offentliggør. En forespørgsel tæller kun som ægte, hvis både navn og IP passer.
| User agent | Påstået | Ægte | Falsk | Andel falske |
|---|---|---|---|---|
| GPTBot | 137 | 27 | 110 | 80 % |
| OAI-SearchBot | 551 | 453 | 98 | 18 % |
| ChatGPT-User | 157 | 56 | 101 | 64 % |
| ClaudeBot | 285 | 176 | 109 | 38 % |
| PerplexityBot | 160 | 51 | 109 | 68 % |
| Perplexity-User | 105 | 0 | 105 | 100 % |
Det er ikke kun AI-navne. Med samme tjek mod Googles officielle liste var 56 % af de forespørgsler, der kaldte sig Googlebot, også falske.
Hvad de falske lavede
De falske forespørgsler læste ikke blogindlæg. De gik efter filer, der aldrig burde være offentlige: /.env, /.env.local, /.npmrc, /.bashrc, /serverless.yml, /firebase-credentials.json, /proc/self/environ og stier til Kubernetes-tokens. På mit site giver de alle 404, hvilket er præcis det, du vil have.
Hvorfor udgive sig for at være GPTBot? Fordi mange siteejere nu lukker AI-crawlere igennem deres firewall eller botbeskyttelse for at kunne dukke op i AI-svar. Hvis den regel kun tjekker user agent, slipper en angriber igennem ved at skrive et navn.
Lektien for sikkerhed: Tillad aldrig en bot ud fra dens user agent alene. Bruger du Cloudflare, så brug deres verificerede bot-kategorier i stedet for user-agent-regler. Skriver du dine egne regler, så tjek IP’en.
Hvad de ægte crawlere lavede
De verificerede crawlere opførte sig pænt. Ægte ChatGPT-User, PerplexityBot og ClaudeBot fik næsten alle deres forespørgsler igennem, og de hentede de sider, man håber på: forsiden, min liste over HARO-alternativer, min SEO-ydelse, min Search Console-guide og min podcastliste. Uden de falske forsvandt problemet med “AI-crawlere, der rammer fejl” helt.
GEO-tallet, analytics ikke kan vise dig
Det her er den del, jeg synes er mest brugbar. ChatGPT-User henter kun en side, når et rigtigt menneske spørger ChatGPT om noget, og ChatGPT beslutter at læse siden for at svare. I samme uge:
- Verificeret ChatGPT-User hentede 14 af mine sider, 56 gange.
- Kun 2 besøg kom fra ChatGPT (ét med chatgpt.com som henvisning, ét tagget utm_source=chatgpt.com).
Det er cirka 28 svar bygget på mine sider for hvert besøg, jeg fik. Ser du kun på analytics, ser du de 2 besøg og konkluderer, at ChatGPT ikke betyder noget. Loggene viser, at ChatGPT læser dit indhold langt oftere, end den sender nogen videre. Til GEO er live AI-hentninger per side et bedre mål for synlighed end klik.
Sådan kører du samme tjek på dit site
1. Find dine adgangslogs
Hos de fleste hosts ligger de i kontrolpanelet eller din hjemmemappe. På CloudPanel ligger de i ~/logs/nginx/, på cPanel under Raw Access. Står du bag Cloudflare, så tjek to ting: at dine logs gemmer den besøgendes rigtige IP (Cloudflare sender den i headeren CF-Connecting-IP), og at de sider, du interesserer dig for, ikke caches hos Cloudflare, for cachede svar når aldrig din server.
2. Hent de officielle IP-lister
Hvert firma offentliggør de IP-intervaller, dets bots bruger, som en lille JSON-fil:
- OpenAI:
openai.com/gptbot.json,openai.com/searchbot.json,openai.com/chatgpt-user.json - Anthropic:
claude.com/crawling/bots.json - Perplexity:
perplexity.com/perplexitybot.json,perplexity.com/perplexity-user.json - Google:
developers.google.com/static/search/apis/ipranges/googlebot.json
3. Kør scriptet
Det her er præcis det script, der lavede tabellen ovenfor. Det kræver kun Python 3. Det forventer klientens IP som det sidste felt i anførselstegn på hver loglinje, som er sådan CloudPanel logger det bag Cloudflare; har du et andet format, så ret den ene linje. Kør det med python3 verify_ai_bots.py access.log.
import ipaddress, json, re, sys, urllib.request
from collections import Counter

# Official IP lists published by each company
LISTS = {
    "GPTBot":          "https://openai.com/gptbot.json",
    "OAI-SearchBot":   "https://openai.com/searchbot.json",
    "ChatGPT-User":    "https://openai.com/chatgpt-user.json",
    "ClaudeBot":       "https://claude.com/crawling/bots.json",
    "PerplexityBot":   "https://www.perplexity.com/perplexitybot.json",
    "Perplexity-User": "https://www.perplexity.com/perplexity-user.json",
}

def load(url):
    data = json.load(urllib.request.urlopen(urllib.request.Request(url, headers={"User-Agent": "Mozilla/5.0"})))
    return [ipaddress.ip_network(p.get("ipv4Prefix") or p.get("ipv6Prefix")) for p in data["prefixes"]]

ranges = {bot: load(url) for bot, url in LISTS.items()}
real, fake = Counter(), Counter()

for line in open(sys.argv[1], errors="replace"):
    for bot in ranges:
        if bot in line:
            ip = re.findall(r'"([0-9a-fA-F.:]+)"\s*$', line)  # client IP as the last quoted field
            ip = ip[0] if ip else line.split()[0]
            ok = any(ipaddress.ip_address(ip) in net for net in ranges[bot])
            (real if ok else fake)[bot] += 1
            break

for bot in ranges:
    total = real[bot] + fake[bot]
    if total:
        print(f"{bot:16} {total:5} claimed  {real[bot]:5} real  {fake[bot]:5} fake ({fake[bot] / total:.0%})")
4. Kig på tre ting
- Andelen af falske. Er den høj, så sørg for, at ingen firewallregel stoler på AI-user-agents.
- Hvilke sider de ægte crawlere henter. Det er de sider, AI-værktøjerne kender dig for. Er dine vigtigste sider ikke på listen, er det din GEO-to-do-liste.
- Live-hentninger (ChatGPT-User, Perplexity-User, Claude-User) per side over tid. Det er det tætteste, du kommer på et mål for AI-synlighed ud fra dine egne data.
Forbehold
- Ét site, én uge. Dine tal vil være anderledes, og derfor er det værd at køre selv.
- IP-listerne ændrer sig. Hent dem friske hver gang; det gør scriptet.
- Anthropics liste er ny, så en ældre guide siger måske stadig, at Claudes IP’er ikke kan verificeres. Det kan de nu.
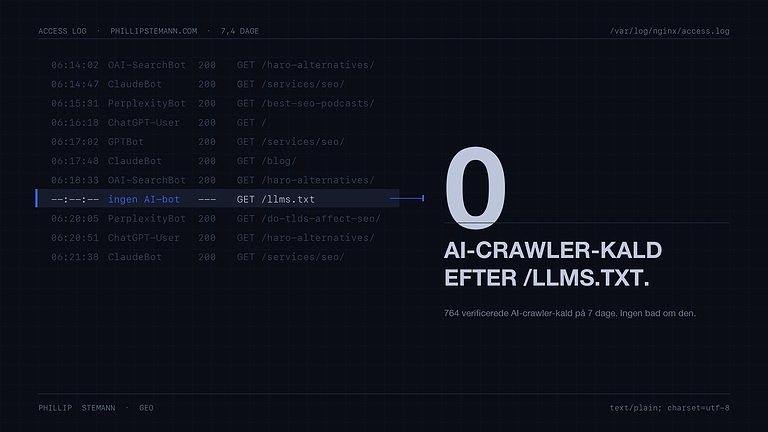
Vil du have det her som en løbende rapport i stedet for et engangsscript, er det en del af min tracking- og analytics-ydelse. Og hvis du undrer dig over, om nogen af crawlerne læste din llms.txt: det tjekkede jeg også.